



T24 Haber Merkezi
Hiçbir kurum, şirket, kişi, fon ve benzeri bir dış kaynaktan destek almadan, finansal ve ideolojik angajmanlardan bağımsız gazetecilik yapmak için 1 Eylül 2009’da yayına başlayan T24’ü, evrensel ölçüde referans gösteren bir araştırmanın sonuçları açıklandı. Stanford Üniversitesi araştırma grubunun yaptığı çalışmada, yapay zekâ platformlarının Türkçe bilgi doğrulama süreçlerinde en çok başvurduğu kaynaklar arasında T24 birinci sırada çıktı.
İstanbul Politikalar Merkezi'nin (İPM) "Yapay Zekâ ve Toplum" seminer serisinin dördüncü buluşmasında, yapay zekâ sistemlerinin haberleri doğrularken hangi kaynaklara başvurduğunu inceleyen dikkati çekici bir araştırma kamuoyuyla paylaşıldı. Google, OpenAI, Microsoft (xAI) ve Anthropic gibi teknoloji devlerinin sohbet robotlarını inceleyen çalışmada, T24 Türkiye’de en çok güvenilen ve alıntı yapılan haber kaynağı olarak birinci sırada yer aldı.
BU HABERİ, T24 ABONELERİNİN DE
SAĞLADIĞI KATKIYLA OKUYORSUNUZ.
T24'E ABONE OL,
BAĞIMSIZ GAZETECİLİĞİ DESTEKLE!
Zaten abone misiniz? Üye girişi yapın
Galatasaray Üniversitesi Hukuk Fakültesi öğretim üyesi Doç. Dr. Zeynep Ayata'nın moderatörlüğünde gerçekleştirilen "Bilgi Ekosistemi" başlıklı seminerde, araştırmacılar Yard. Doç. Dr. Onur Varol ve Gülin Çavuş yapay zekâ modellerinin haber doğrulama süreçlerine ilişkin bulguları değerlendirdi. 8 Haziran'da İPM Karaköy'de düzenlenen etkinlikte, Stanford Üniversitesi’nde sekiz araştırmacı (Mirac Suzgun, Emily Shen, Federico Bianchi, Alexander Spangher. Thomas Icard, Daniel E. Ho, Dan Jurafsky, James Zou)tarafından yürütülen araştırma ele alındı.
Gemini, ChatGPT, Claude, Grok gibi yapay zekâ sohbet botlarının, haber aracıları olarak güvenilirliğini mercek altına alan çalışmada, 14 gün boyunca, İngilizce, Fransızca, Arapça, Hintçe, Rusça ve Türkçe olmak üzere altı dilde toplam 12 bin 600 soru yöneltilerek, yapay zekânın güncel haberleri doğrulama kapasiteleri test edildi.
Araştırmanın genel çerçevesi, yapay zekânın haber okuma alışkanlıklarını nasıl şekillendirdiğini ve "arama destekli üretim" (RAG) sistemlerinin sınırlarını ortaya koymak üzerine kurulu.
T24, Türkçe aramalarda ilk sırada
Araştırmanın en dikkat çekici sonuçlarından biri, yapay zekâ modellerinin Türkçe haberlerle ilgili sorulara yanıt verirken bilgi doğrulama sürecinde en sık başvurduğu kaynağın T24 olması oldu.
Çalışmanın "Bölgelere Göre En Çok Alıntı Yapılan Alan Adları" (Top Sited Domains by Region) analizinde altı farklı yapay zekâ modelinin 14 gün boyunca verdiği yanıtlar incelendiğinde T24 günde ortalama 12,6 atıfla Türkçe ekosistemde ilk sırada yer aldı. Yapay zekâ araçlarının Türkçe bilgi doğrulama süreçlerinde birinci sırada referans aldığı T24'ü İngilizce Wikipedia (11,4), Anadolu Ajansı (10,6) ve BBC (10,4) takip etti. Cumhuriyet, Haberler.com ve The Guardian bu alanda yapay zekâ platformlarının en sık kullandığı diğer kaynaklar arasında yer aldı.
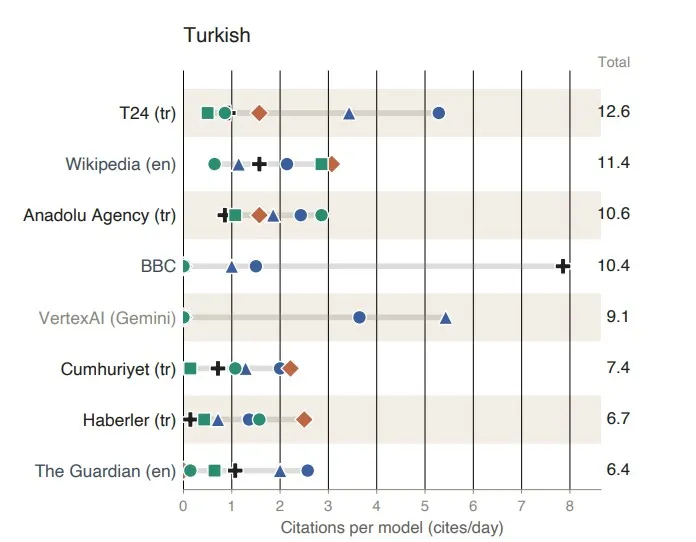
Tabloda mavi renkle gösterilen kaynaklar, ilgili bölgenin veya dilin ana dili dışında yayın yapan kaynakları ifade ediyor. Araştırmacılar bunu "Anglophone retrieval pivot" yani "İngilizce merkezli erişim kayması" olarak tanımlıyor. Türkçe bölümünde mavi renkle gösterilen Wikipedia, BBC ve The Guardian gibi kaynaklar İngilizce yayın yapan kuruluşlar.
Buna karşılık T24, Anadolu Ajansı, Cumhuriyet ve Haberler.com gibi Türkçe yayın yapan kaynaklar siyah renkle gösteriliyor.
Araştırma aynı zamanda yapay zekâ sistemlerinin yerel haberleri yanıtlarken bile sıklıkla İngilizce kaynaklara yöneldiğini ve yerel bilgi ekosistemlerini küresel İngilizce içeriklerin süzgecinden geçirerek yeniden ürettiğini gösteriyor.
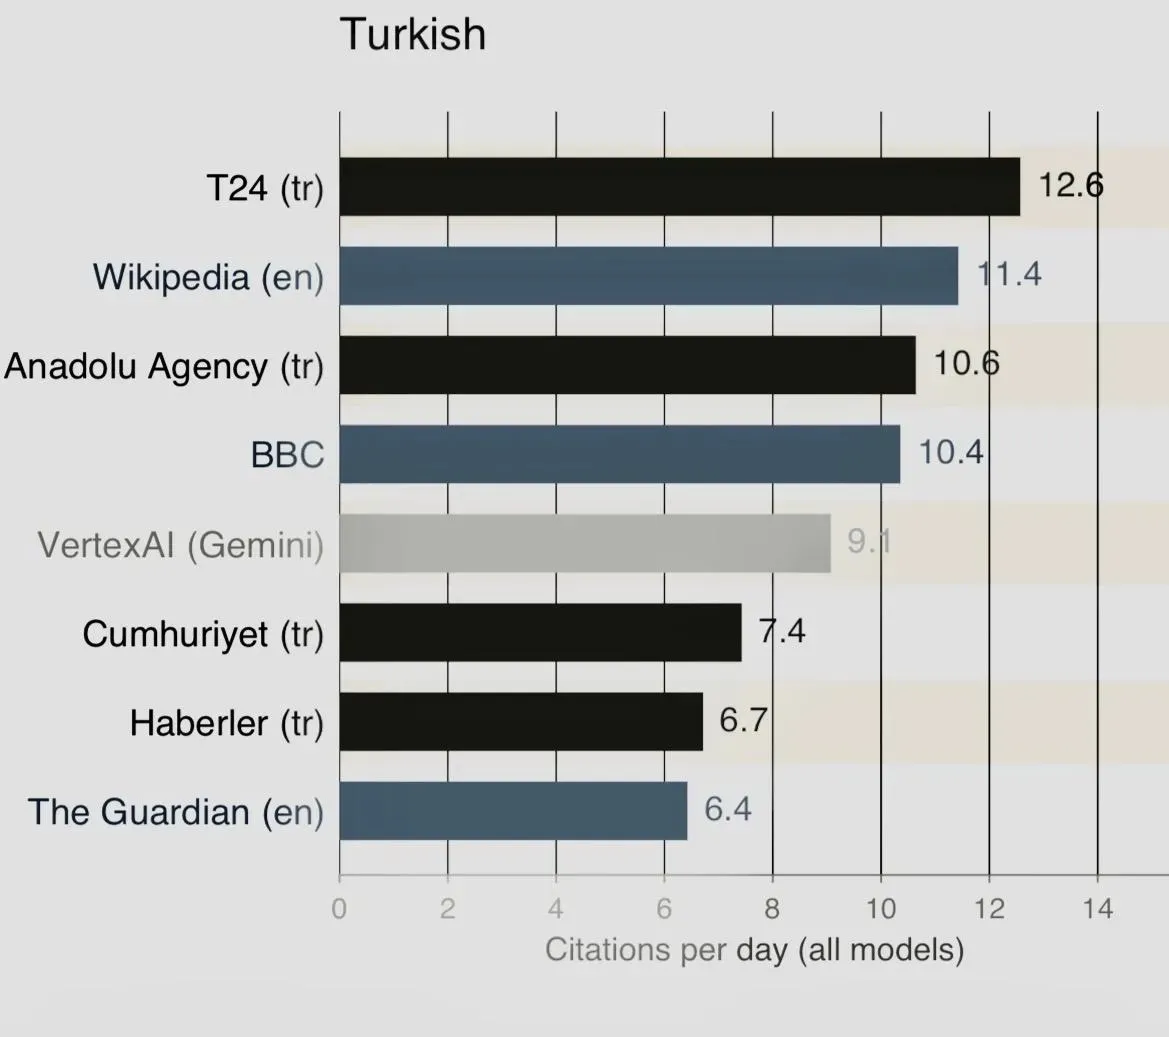
Araştırmanın Türkiye odaklı veri analizinde yer alan "Model Dağılım Grafiği", küresel yapay zekâ devlerinin yerel haber kaynaklarıyla olan ilişkisini ortaya koyuyor.
Grafikte yer alan her bir geometrik şekil farklı bir yapay zekâ modelini (Mavi Yuvarlak: Gemini Flash, Mavi Üçgen: Gemini Pro, Siyah Artı: Grok 4, Kırmızı Baklava: Claude 4.5, Yeşil Yuvarlak: GPT-5, Yeşil Kare: GPT-4o Mini) simgelerken, sembollerin satır üzerindeki konumu o modelin ilgili kaynağa yaptığı günlük atıf yoğunluğunu gösteriyor.
Günlük ortalama 12,6 alıntı ile Türkiye listesinin zirvesinde yer alan T24 (tr) satırında, özellikle OpenAI'ın yeni nesil modelleri (GPT-5 ve GPT-4o Mini) ile Anthropic (Claude 4.5) modellerini temsil eden yeşil ve kırmızı ikonların en sağda kümelenmesi, dünyanın en popüler sohbet robotlarının Türkiye gündemini kullanıcılarına aktarırken birincil referans olarak T24’ü seçtiğini gösteriyor.
"Türkçe için en temel kaynak T24”
Sabancı Üniversitesi Bilgisayar Bilimi ve Mühendisliği bölümü öğretim üyelerinden Yard. Doç. Dr. Onur Varol, Stanford Üniversitesi araştırma ekibinin çalışmasını yorumladı. Çevrim içi veri analizleri ve modellemeler yapan Varol, araştırma sonuçlarını yorumlarken, “Türkçe için en temel kaynak T24. Sonra Wikipedia, sonra AA geliyor, sonra da uluslararası kaynaklar veya lokaldeki haber ajansları geliyor... Birisi gidip Wikipedia'yı yeniden yazmaya başlarsa ya da inandırıcı gözüken bir haber kanalını main stream (ana akım) hâle getirirse, daha görünür kılarsa bu modeller de o veriyle beslenecekler” görüşünü dile getirdi.
Seminerde araştırmanın sonuçlarını değerlendiren Gülin Çavuş da, T24'ün listenin başında yer almasının tesadüf olmadığını, bağımsız medya kuruluşlarının yapay zekâ çağında yeni bir mücadele alanıyla karşı karşıya olduğunu söyledi. Çavuş, T24’ün ilk sırada çıktığı araştırmayı değerlendirirken, "Bağımsız medya kuruluşları ya da işte T24'ün çıkması da bir yandan çok iyi, bir yandan anlamlı” dedi. Çavuş, sonucu “T24’ün SEO (arama motoru optimizasyonu) içerik üretmeye çok odaklanması ve gelir modelini buna oturtmuş olması” yorumuna dayandırdı.
T24’ün notu: T24, bugüne kadar SEO içerik üretmeye editör ve kaynak ayırmadı, ayıramadı.
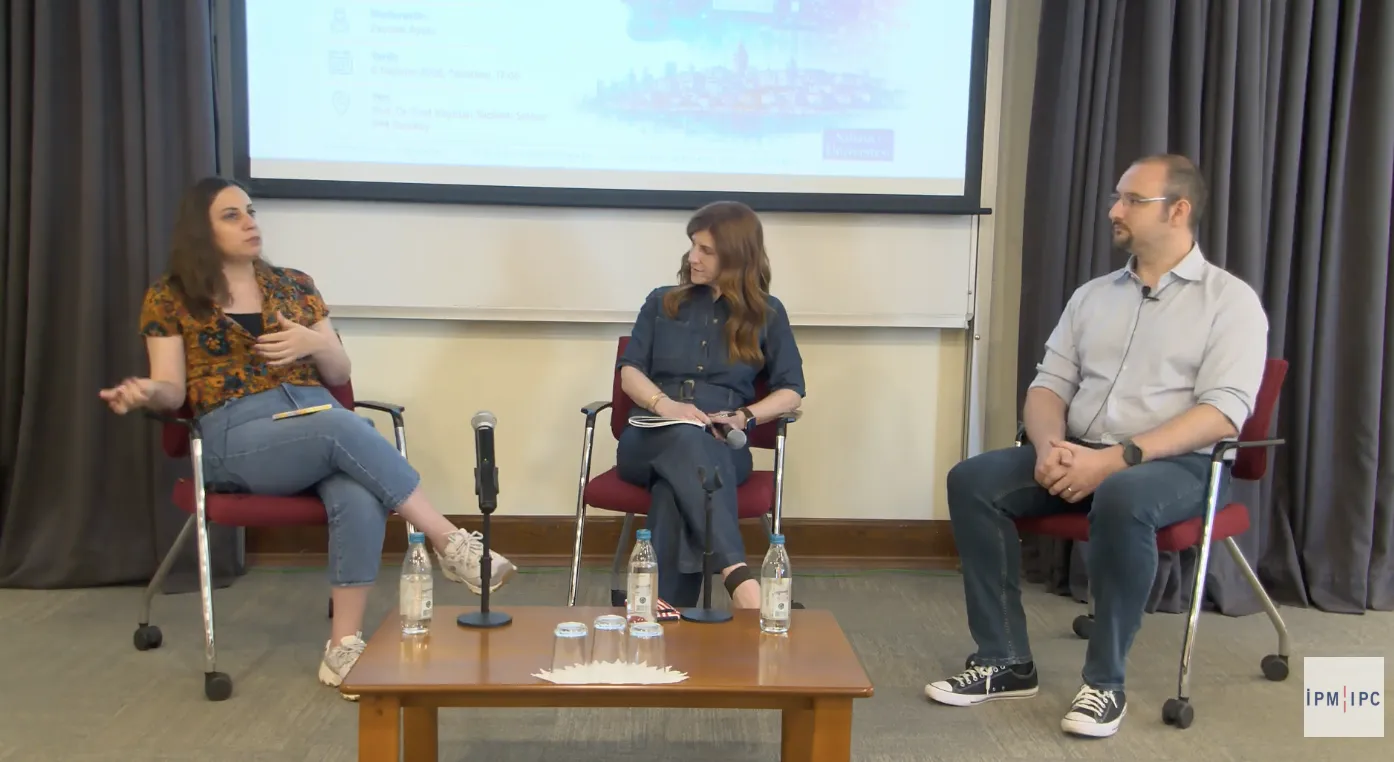 İPM'nin düzenlediği, kıdemli uzman Zeynep Ayata öncülüğünde başlatılan "Yapay Zekâ ve Toplum" seminer serisinin "Bilgi Ekosistemi" başlıklı dördüncü buluşması, Gülin Çavuş (solda) ve Onur Varol'un (sağda) katılımıyla ve Zeynep Ayata'nın moderatörlüğünde 8 Haziran'da yapıldı
Yapay zekâ haberleri kimden öğreniyor?
Araştırma, yapay zekâ sistemlerinin yalnızca ne kadar doğru cevap verdiğini değil, bilgiyi hangi kaynaklardan aldığı sorusunu da gündeme taşıyor.
Araştırmacılar, yapay zekâların gelecekte bilgiye erişimde birincil aracı hâline gelmesi durumunda hangi kaynakların görünür olduğuna ve hangi yayınların referans alındığının demokratik bilgi ekosistemi açısından kritik önem taşıdığına dikkat çekiyor.
Çavuş da seminerde bu noktaya vurgu yaparak, medya kuruluşlarının ürettikleri içeriklerin yapay zekâ sistemleri tarafından kullanıldığı hâlde karşılığında herhangi bir ekonomik modelin oluşmadığını, bu nedenle içerik üreticileri ile yapay zekâ şirketleri arasında yeni bir ilişkinin tartışılması gerektiğini vurguladı.




