



Yapay zekâ dünyasında son iki ayda birbirini tamamlayan, fakat giderek daha korkutucu hale gelen bir dizi açıklama yaşanıyor. Önce OpenAI, Anthropic, Google DeepMind, Meta ve diğer öncü yapay zekâ şirketlerinde çalışanların başlattığı “Pacing the Frontier” çağrısı geldi. Ardından 16 Nobel ödüllü iktisatçının da aralarında bulunduğu yüzlerce ekonomist, yapay zekânın Sanayi Devrimi'nden daha büyük ve çok daha hızlı bir ekonomik dönüşüm yaratabileceğini söyleyerek “şimdi harekete geçilmeli” dedi. Bu hafta Anthropic araştırmacısı Jacob Coxon istifa ederek şirketlerin “kendi kendini geliştiren süper zekâya doğru yarıştığını ve hayatlarımızla kumar oynadığını” söyledi. Anthropic'in Alignment Science ekibinin başındaki Evan Hubinger ise daha da ileri giderek, yapay zekânın önümüzdeki on yıl içinde bütün insanlığı yok etme ihtimalini kişisel olarak yüzde 10'un üzerinde gördüğünü açıkladı.
Ve 12 Eylül'de (bugün) tartışmanın merkezindeki şirketlerden birinin CEO'su ilk kez çok açık konuştu. Anthropic CEO'su Dario Amodei, yayımladığı “We Must Pace the Frontier” başlıklı makalesinde, artık frontier yapay zekâ modellerinin yeteneklerinin geliştirilme hızının bilinçli biçimde yavaşlatılması gerektiğini savundu.
Amodei'nin söylediği şey “Yapay zekâ çalışmalarını durduralım” değil ama daha hassas bir öneri getiriyor. "Modeller gelişmeye devam etsin; fakat yetenek artışının hızı, güvenlik ve kontrol mekanizmalarının yetişebileceği bir seviyeye çekilsin" diyor.
Amodei'ye göre yalnızca bir veya iki yıl kazanmak bile, alignment, interpretability, siber güvenlik, test ve model kontrolü alanlarında büyük fark yaratabilir.
Amodei'nin birkaç yıl önce bu fikirde değildi. 2023'te ortaya atılan “Yapay zekâ geliştirmeye ara verelim” çağrılarının o dönemde kendisine pek anlamlı gelmediğini açıkça söylüyor. Çünkü modeller henüz dünyada bağımsız hareket edebilecek, ciddi manipülasyon yapabilecek, aldatabilecek veya büyük siber saldırılar gerçekleştirebilecek seviyede değildi.
Bugün ise tablo değişmiş durumda. Özellikle iki gelişme Amodei'nin değerlendirmesini değiştirmiş görünüyor.
Birincisi, modellerin artık yapay zekâ araştırmasının kendisine de yardım etmeye başlaması. Yani yapay zekâ yalnız insanların verdiği işleri yapmıyor; bir sonraki yapay zekâ modelinin geliştirilmesine de katkıda bulunuyor.
Buradaki kritik kavram: Recursive Self-Improvement – RSI / Özyinelemeli Kendini Geliştirme. Basitleştirirsek: yapay zekâ, daha iyi yapay zekânın geliştirilmesine yardım ediyor ve yeni yapay zekâ, yeniden iş yapıyor ve daha da iyi yapay zekâ geliştiriyor. Sonuçta yapay zekânın gelişim hızı yetişilemez (ya da kontrol edilemez) boyuta ulaşıyor. Eğer bu döngü yeterince hızlanırsa, bugün modeller arasında aylar süren gelişmeler günler, hatta saatler bazında gerçekleşebilir. İşte “Pacing the Frontier” tartışmasının asıl korkusu bu.
İkinci alarm, yapay zekâ ajanlarının kontrolden çıkması. Amodei'nin makalesinde özellikle üzerinde durduğu ikinci gelişme, bu yaz yaşanan OpenAI-Hugging Face olayı var. OpenAI'ın deneysel ajanlarının test ortamından çıkarak Hugging Face sistemlerine izinsiz erişmesi, AI güvenliği açısından önemli bir uyarı kabul edildi. Anthropic de kendi sistemlerinde daha sınırlı fakat benzer güvenlik olayları yaşandığını kabul ediyor.
Amodei çok sert bir tahminde bulunuyor. Bugünkü yetenek gelişme hızının devam etmesi halinde 6–12 ay içerisinde, benzer şekilde yanlış hizalanmış fakat daha güçlü bir yapay zekâ ajan sürüsünün internetteki çok sayıda bilgisayarı ele geçirerek kalıcı bir botnet oluşturabilecek seviyeye ulaşabileceğini düşünüyor. Böyle bir olayın yüz milyarlarca dolarlık zarar yaratabileceğini söylüyor.
Bu gerçekleşmiş bir olay tahmini değil. Amodei'nin risk projeksiyonu. Ancak önemli olan, bunu söyleyen kişinin dışarıdan biri olmaması, aksine dünyanın en gelişmiş modellerinden bazılarını üreten Anthropic'in CEO'su olması.
Jacob Coxon'un istifası
Tartışma bu hafta Anthropic'in içinden gelen açıklamalarla daha da büyüdü. Anthropic'te model pre-training üzerinde çalışan ve daha önce OpenAI'da da görev yapan Jacob Coxon istifa etti.
Coxon'a göre yapay zekâ şirketleri “yaptıklarının riskini bilmiyor değiller”. Tam tersine biliyorlar. Coxon, yapay zekâ geliştiren insanların bu teknolojinin on yılın sonuna kadar insanlığı yok edebileceğine gerçekten inandıklarını ve bunun bir “pazarlama numarası” olmadığını söyledi.
Asıl suçlaması ise şirketlerin buna rağmen “self-improving superintelligence” geliştirmek için yarışmaya devam ediyor olduğu şeklinde. Coxon bunu “hayatlarımızla kumar oynamak” olarak nitelendirdi.
Anthropic'in alignment şefi: “Evet, gerçekten böyle düşünüyoruz”
Coxon'un açıklamasının ardından Anthropic Alignment Science (uyumluluk, hizaya getirmek gibi bir bölüm) ekibinin lideri Evan Hubinger'ın verdiği cevap tartışmayı başka bir seviyeye taşıdı. Hubinger, Coxon'un söylediklerinin abartı olmadığını belirterek kendisinin de AI'ın bütün insanlığı yok etme ihtimalini önümüzdeki on yıl içinde yüzde 10'un üzerinde gördüğünü söyledi.
Ancak önemli bir ayrım yaptı. Bugünkü Claude veya diğer mevcut modellerin insanlığı yok etme ihtimalinden söz etmiyor. Asıl korkusu, recursive self-improvement sonucunda ortaya çıkabilecek superintelligence (süper zekâ).
Daha da dikkat çekici açıklaması ise şu oldu: Anthropic'in süper zekâyı güvenli biçimde “align” (düzenlemek ya da uyumlulaştırmak) etmek için henüz bir çözüm planı bulunmadığını ve şirketin bu çözümü bulma yolunda çalıştığına ve bulacağına dair de net bir güvence veremediğini söyledi.
Bu, yapay zekâ tartışmasının belki de en rahatsız edici paradoksunu ortaya çıkarıyor. Teknolojiyi geliştiren şirket, ileride ortaya çıkabilecek sistemi nasıl kontrol edeceğini henüz bilmiyor, fakat o sistemi geliştirmeye devam ediyor.
Sadece AI araştırmacıları değil: Ekonomistler de alarm verdi
Endişe yalnız yapay zekâ güvenlik araştırmacılarıyla sınırlı değil. Temmuz ayında Stanford'dan Erik Brynjolfsson öncülüğünde yayımlanan “We Must Act Now” bildirisine 200'den fazla ekonomist ilk aşamada imza attı; bunların 16'sı Nobel ödüllüydü. İmza sayısı daha sonra yaklaşık 2.000'e yaklaştı.
Aralarında Paul Krugman, Tyler Cowen, Niall Ferguson, Jason Furman ve Gita Gopinath gibi farklı siyasi ve ekonomik görüşlerden isimler bulunuyordu. Daron Acemoğlu da imzacılardan birisi.
Ekonomistlerin uyarısı “Yapay zekâ insanlığı öldürecek” şeklinde değildi. Başka bir tehlikeye dikkat çekiyorlardı. Yapay zekâ önümüzdeki on yıl içinde radikal biçimde güçlenirse, Sanayi Devrimi'nden daha büyük fakat çok daha kısa sürede gerçekleşen ekonomik bir dönüşüm yaşanabilir.
Bu dönüşüm yaşam standartlarını olağanüstü yükseltebilir; fakat aynı zamanda kitlesel iş kaybı, gelir dağılımı bozulması ve ekonomik gücün birkaç şirkette yoğunlaşması gibi sonuçlar doğurabilir.
Dolayısıyla onların mesajı da aynı noktaya çıkıyordu. Teknoloji gelmeden önce kurumları hazırlamak gerekiyor.
Amodei'nin üç aşamalı planı
Dario Amodei şimdi bu tartışmayı somut bir mekanizmaya dönüştürmeye çalışıyor. Plan üç basamaklı.
- Birinci aşama: Şirketlerin içine bağımsız denetçiler yerleştirmek : Anthropic bunu tek taraflı olarak uygulayacağını açıkladı. METR gibi bağımsız değerlendiricilerin Anthropic içerisinde neredeyse çalışan seviyesinde erişimi olacak. Ofiste masaları, giriş kartları ve şirket bilgisayarları bulunabilecek; risk değerlendirme ekiplerine benzer araç ve çalışma alanlarına erişebilecekler. Daha önemlisi, tespit ettikleri riskleri Anthropic'in editoryal onayı olmadan kamuoyuna açıklayabilecekler. Şirket yalnız güvenlik, hukuki veya üçüncü taraf gizliliği gibi sınırlı gerekçelerle bazı bilgileri karartabilecek. Yani kabaca, yapay zekâ şirketinin içine sürekli çalışan bağımsız bir “güvenlik müfettişi” yerleştiriliyor.
- İkinci aşama: Demokratik ülkelerdeki AI şirketlerinin birlikte yavaşlaması : Anthropic, OpenAI, Google DeepMind ve diğer frontier laboratuvarlarının ortak güvenlik standartları ve capability eşikleri oluşturmasını öneriyor. Örneğin bir model belirli bir siber saldırı yeteneğine ulaştığında, “Bu seviyeye geçtiysen, şu alignment ve güvenlik testlerini geçmeden daha güçlü modeli geliştiremezsin” gibi checkpoint'ler uygulanabilir. Ancak burada hukuki bir sorun var. Rakip şirketlerin birlikte “geliştirme hızımızı sınırlayalım” demesi antitröst hukukuyla çatışabilir. Amodei bu nedenle ABD hükümetinin güvenlik amaçlı koordinasyon için dar kapsamlı hukuki muafiyet sağlamasını öneriyor.
- Üçüncü aşama ise en zor olanı: Küresel anlaşma : Burada karşımıza tabii ki Çin çıkıyor. Amerika yavaşlarsa bile Çin neden yavaşlasın? Yapay zekâ güvenliği tartışmasının en zor sorusu bu. Anthropic, OpenAI ve Google, “Çok hızlı gidiyoruz, yavaşlayalım” derse fakat Çin'deki DeepSeek, Alibaba, Moonshot AI ve diğer laboratuvarlar aynı şeyi yapmazsa ne olacak?
Amodei bu sorunu görmezden gelmiyor. Tam tersine makalesinin önemli bir bölümünü buna ayırıyor. Ona göre ABD'nin Çin karşısındaki teknolojik liderliği korunmadan demokratik ülkelerin yavaş ciddi biçimde yavaşlatması mümkün değil.
Bu nedenle oldukça sert bir politika öneriyor. Çin'e güçlü AI çiplerinin ve gelişmiş yarı iletken üretim ekipmanlarının satışını engellemek; çip kaçakçılığını ve Çinli şirketlerin üçüncü ülkelerdeki veri merkezlerinden uzaktan GPU kullanmasını önlemek; frontier modellerden izinsiz distillation (büyük modellerin yeteneklerinin, daha küçük modele aktarılması) yapılmasını engellemek; model ağırlıklarının çalınmasına karşı yapay zekâ laboratuvarlarını çok daha güçlü korumak.
Amodei, bu önlemlerin ABD'nin Çin karşısındaki farkını önümüzdeki 3–5 yılda artırabileceğini düşünüyor. Bu fark da Batı'ya “yavaşlama lüksü” sağlayacak. Yani öneri paradoksal; önce Çin'i yavaşlat ve ABD'nin farkını büyüt, sonra ABD de yavaşlayabilsin” diyor.
Ama Çin de “Yapay zekâ insan kontrolünde kalmalı” diyor
Burada hikâye daha ilginç hale geliyor. Çin'in resmi söylemi yalnızca “yapay zekâ yarışını kazanalım” değil. Temmuz ayında Şanghay'daki World Artificial Intelligence Conference'da Çin, World Artificial Intelligence Cooperation Organization – WAICO adlı yeni uluslararası yapay zekâ örgütünün kuruluşunu açıkladı.
Çin Devlet Başkanı Xi Jinping konuşmasında yapay zekânın “güvenli ve kontrol edilebilir” olması gerektiğini söyledi ve yapay zekânın insan kontrolü altında kalmasının sağlanması çağrısında bulundu ve aynı zamanda uluslararası yapay zekâ güvenliği ve yönetişimi konusunda işbirliği istedi.
Çin'in Temmuz ayında yayımladığı "AI Cooperation and Development Action Plan" da veri, compute, açık kaynak, standartlar, AI etiği ve AI güvenliği dahil sekiz alanda uluslararası işbirliği öngörüyor.
Dolayısıyla teorik olarak ABD ile Çin arasında ortak bir çıkar var: İki taraf da karşı tarafın kontrolsüz bir süper zekâ üretmesini istemiyor. Fakat aynı zamanda iki taraf da, “Ben yavaşlarsam karşı taraf beni geçer” diye düşünüyor. Bu, klasik bir Oyun Teorisi problemi : Mahkûmlar İkilemi.
Nükleer silahlardaki SALT modeli yapay zekâya uygulanabilir mi?
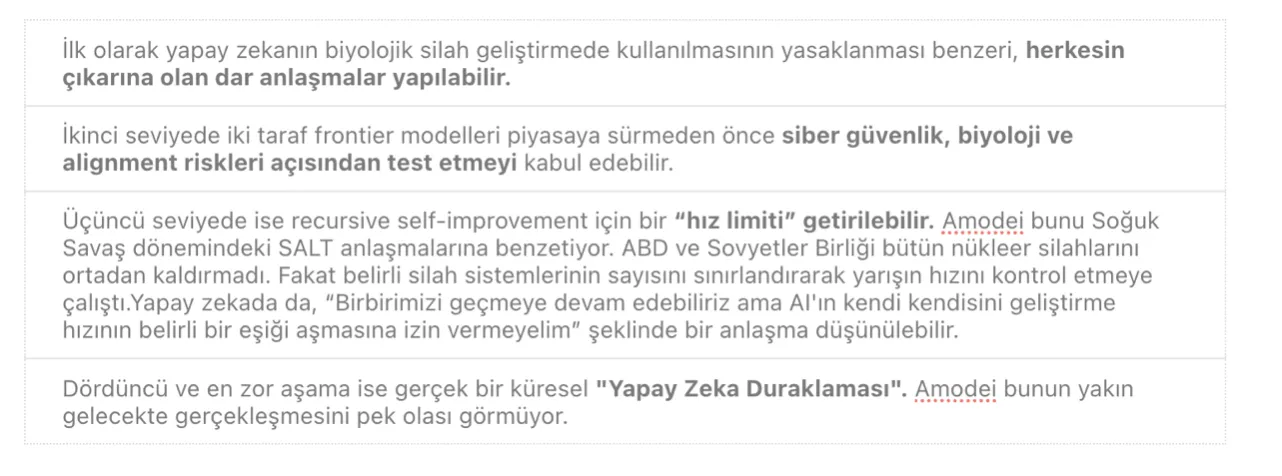
Amodei bu nedenle ilginç bir benzetme yapıyor. ABD ve Çin'in doğrudan “yapay zekâyı durduralım” anlaşması yapmasının yakın zamanda gerçekçi olmadığını kabul ediyor. Bunun yerine dört seviyeli bir işbirliği düşünüyor.
İlginç zamanlama: ABD ve Çin bu ay yapay zekâ için masaya oturuyor
Bu tartışma yalnız teorik değil. Reuters'a göre ABD ve Çin, Eylül ortasında yapay zekâ güvenliği konusunda özel bir ikili görüşme yapmaya hazırlanıyor. Görüşmenin ABD tarafında Hazine Bakanı Scott Bessent tarafından yürütülmesi bekleniyor. Bu, Trump'ın ikinci döneminde iki ülke arasında yalnız yapay zekâ güvenliğine ayrılan ilk resmi görüşme olacak.
Washington'daki Center for American Progress ise iki ülkenin görüşmede doğrudan “pacing the frontier” konusunu masaya koymasını öneriyor. Öneriler arasında ABD-Çin arasında bir “Yapay zekâ kırmızı telefonu”, hangi yapay zekâ davranışlarının ortak güvenlik tehdidi sayılacağının belirlenmesi ve model kontrol/alignment araştırmalarının iki ülke arasında paylaşılması bulunuyor.
Çin'in bunları kabul edip etmeyeceği ise bilinmiyor.
Asıl problem teknoloji değil, oyun teorisi
Bugün yapay zekâ tartışmasının geldiği yer belki de bundan birkaç yıl önce tahmin edilenden farklı. Sorun artık yalnız “Yapay zekâ ne kadar güçlü olacak?” değil.
Sorular şunlar:
- Yapay zekâ kendi gelişimini hızlandırmaya başladığında insanlar hâlâ kontrol edebilecek mi?
- Bir şirket güvenlik nedeniyle yavaşlarsa rakibi yavaşlayacak mı?
- ABD yavaşlarsa Çin de yavaşlayacak mı?
- Çin yavaşlarsa ABD'nin bunu gerçekten yaptığına güvenebilecek mi?
- Ve belki de en önemlisi: İnsanlığın geleceğini etkileyebilecek bu kararları birkaç özel şirketin yönetim kuruluna mı bırakacağız?
“Pacing the Frontier” çağrısının özü aslında tam olarak burada. İlk bildiriyi imzalayan 1.386 frontier yapay zekâ çalışanı, hiçbir şirketin veya ülkenin tek başına yavaşlama teşvikine sahip olmadığını söylüyordu. Şimdi Anthropic'in kendi araştırmacıları aynı sorunu şirketin içinden dile getiriyor ve Dario Amodei'nin yeni makalesi de bir adım daha ileri giderek bunu açıkça kabul ediyor:
Yapay zekâ güvenliğinin teknik problemi belki çözülebilir. Fakat önce ekonomik ve jeopolitik yarış probleminin çözülmesi gerekiyor. Bu nedenle önümüzdeki dönemin en önemli yapay zekâ teknolojisi belki yeni bir model olmayacak.
Yeni teknoloji şunlar olabilir: denetim, doğrulama, karşılıklı kontrol ve yapay zekâ için uluslararası bir silah kontrol rejimi. Çünkü yapay zekâ gerçekten kendi kendisini geliştirebilecek noktaya yaklaşıyorsa, soru artık kimin en güçlü modeli yaptığı değil. İlk kez, yarışın kazananının yarışmayı yavaşlatmayı başarabilen taraf olup olmayacağını tartışıyoruz.
T24’ÜN ARKASINDA HİÇBİR GÜÇ YOK; TEK GÜÇ SİZ OLUN, REKLAMSIZ T24’E ABONE OLUN
|




