



Geçtiğimiz hafta İngiltere merkezli The Guardian gazetesindeki bir haber dikkatimi çekti. Haber, Harvard Tıp Fakültesi’nden bir grup araştırmacının çalışmasını özetliyordu. Çalışma, iki farklı senaryoda OpenAI’ın iki farklı dil modeli o1 ve ChatGPT 4 ile, uzman ve asistan hekimlerden oluşan doktorların tıbbi konulardaki becerilerini kıyaslıyordu.
Çalışmanın ilk kısmında, tıp dünyasındaki prestijli dergilerden biri olan New England Journal Medicine (NEJM)’nin tarihi klinik vaka konferansları, sanal hasta senaryoları ve uzman hekimlerce hazırlanmış tedavi planlaması vakaları gibi beş farklı simülasyon ortamında dil modelleri ile doktorlardan oluşan ekiple kıyaslanmış. Kıyaslamanın sonunda ise tüm kategorilerde modellerin, doktorların üzerinde bir performans sergilediği gözlemlenmiş.
Çalışmanın ikinci kısmı ise Boston’daki bir hastanenin acil servisinden rastgele seçilen 76 hastanın tıbbi geçmişini merkeze almış. Hem doktorlara hem de dil modellerine hastalara ait aynı elektronik kayıt verilmiş ve sonunda ilk triyajda dil modellerinin %67, doktorların ise %50-55 oranında doğru teşhisi koyduğu görülmüş.
The Guardian’daki haber de çalışmanın özellikle bu ikinci kısmın öne çıkarmış ve sansasyonel bir başlıkla yapay zekânın doktorlardan daha iyi performans gösterdiğini belirtmiş. Elbette güncel hype ortamına oldukça uygun bu başlık dikkatlerden kaçmadı ve X platformunda Türkçe ve İngilizce hesaplarca paylaşıldı.
Bu köşenin bir takipçisiyseniz eğer, bu girişten sonra gelecek “sihirli” kelimeyi de tahmin etmişsinizdir muhtemelen.
Peki bu çalışmadaki sonuçlar gerçek hayat için referans olabilir mi?
Cevap, hayır. Çalışmadaki senaryolar, gerçek hayatın karmaşık halini yansıtmaktan uzak. Yani önceki yazılarda farklı konular üzerinden altını çizdiğim bir handikap burada da kendisini gösteriyor. Bu modeller "ideal" koşullarda, kendilerine verilen girdilerin belirlediği çerçeve içinde iyi çalışıyor. Fakat gerçek hayatta öğrendikleri örüntülerin dışına çıkan bir durum geliştiğinde sonuç çoğunlukla başarısızlık oluyor. Literatürde bu hipotezi doğrulayan çok sayıda çalışma mevcut. Üstelik bu handikap, çalışmayı yürüten araştırmacıların da gözünden kaçmıyor elbette.
Nitekim çalışmanın kıdemli ortak yazarlarından Harvard'dan Raj Manrai, X'te yaptığı bir açıklamayla bulguların ne anlama geldiğini açıkça ortaya koyuyor. Manrai'ye göre bu sonuçların asıl çağrısı prospektif klinik deneyler yapmak, sağlık sistemlerinin altyapı yatırımına yönelmesi ve sadece tanı doğruluğunu değil güvenliği, verimliliği ve maliyeti de izleyen denetim çerçeveleri kurmak. Yani çalışmanın yazarı bile bulguları tek başına yapay zekânın doktorların önüne geçtiğinin ilanı olarak okumuyor.
Aynı çalışmayı bir de bu alanın bilinen otoritelerinden Amerikan kardiyolog Eric Topol'un gözünden okumakta fayda var. Topol, dünyanın önde gelen bilim dergilerinden Science'da yayımlanan bu çalışmayı Ground Truths bülteninde değerlendirirken önemli bir noktanın altını çiziyor. Çalışmadaki altı deneyin tamamı hasta vakası vinyetleri, simülasyonlar ve hasta rolündeki aktörler üzerinden yürütülmüş. Yani Boston'daki acil servis senaryosu da elektronik kayıtlar üzerinden kurulmuş bir simülasyon. Topol'un ifadesiyle hekimlik pratiğinin "düzensiz, dağınık" gerçekliğini temsil eden bir ortam değil. Bu da çalışmanın bulgularını "potansiyel" olarak konumlandırıyor, gerçek hayatta doktorların yerini alabileceğine dair kesin bir kanıt olarak değil.
Peki gerçek dünyaya yaklaştıkça ne oluyor?
Nature Medicine'da yayımlanan bir başka çalışma, ChatGPT'nin hastaları evde mi kalmaları yoksa acile mi gitmeleri gerektiği konusunda triyaj etmesini test etmiş. Test sonucunda, ChatGPT’nin diyabet ve solunum yetmezliğinin eşiğindeki vakalar gibi gerçek acil durumlarda ciddi teşhis hataları yaptığı görülmüş. Yine Nature Medicine'da yayımlanan başka bir randomize çalışmada on farklı tıbbi senaryoda hastaların büyük dil modelleriyle birlikte aldığı kararlar değerlendirilmiş. Hastaların performansı düşük çıkmış ve yazarlar makaleyi sistematik insan testlerinin sağlık sektöründe halka açık devreye almadan önce zorunlu olduğu uyarısıyla bitirmiş.
İşin bir başka yüzü de hastanın yapay zekâya aktardığı bilginin niteliği. Geçtiğimiz günlerde yayımlanan başka bir çalışma, hastaların belirtilerini bir yapay zekâya tarif ederken, aynı belirtileri bir doktora tarif ettikleri zamana kıyasla daha eksik ve daha düşük kaliteli bilgi paylaştıklarını ortaya koyuyor. Yani modelin çıktısı tek başına onun gerçek başarısını anlatmıyor, çünkü modelin önüne konan girdi hekim muayenesi sırasındaki girdiyle aynı zenginlikte değil.
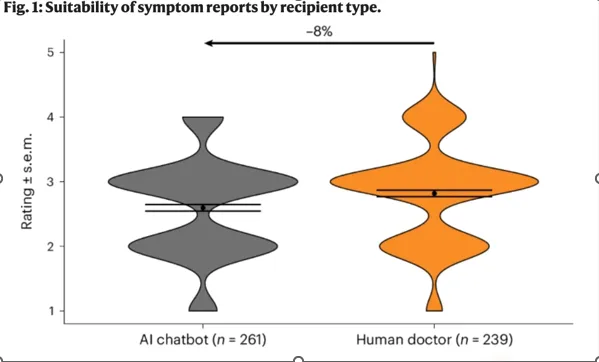 Figür 1: İnsanlar bir AI chatbotla konuştuklarını düşündüklerinde semptomlarını %8 daha az ayrıntılı aktarıyor.
Buraya kadar yazılanların aslında aynı meseleyi farklı yüzlerinden anlattığını fark etmişsinizdir. Dil modelleri kontrollü laboratuvar koşullarında, üzerinde özenle hazırlanmış vakalar üzerinde, hata payı sıkı denetim altındaki yapay senaryolarda doktorların önüne geçebiliyor. Ne var ki tıp pratiği bu kontrollü ortamlardan ibaret değil. Hasta da net bir vinyet değil, eksik anlatan, yanlış hatırlayan, çelişkili belirtiler aktaran, sonradan başka semptomlar ekleyen bir insan. Acil servisteki triyaj kararı da yalnızca elektronik kayıtların okunmasından ibaret değil; hastayla göz teması, refakatçinin yorumu, anlık fizik bulgu, tecrübeyle gelen önsezi gibi modele aktarılması imkânsız sinyaller de bu kararın bir parçası.
Peki yapay zekânın tıp dünyasıyla teması yalnızca dil modelleri üzerinden mi sürüyor?
Bu noktada kendi Substack bültenimden kısa bir parantez açmak isterim. Geçtiğimiz hafta “Yapay Gündemler” isimli bültenimde radyoloji alanı için benzer bir tabloyu paylaşmıştım. Yapay zekânın babalarından Nobel ödüllü Geoffrey Hinton on yıl önce radyolojistleri eğitmeyi durdurmamız gerektiğini, beş yıl içerisinde modellerin tıbbi resimleri taramada insanların önüne geçeceğini söylüyordu. Aradan geçen on yılın ardından ortaya çıkan tablo ise tam tersi yönde. Apollo’dan Torsten Slok'un paylaştığı verilere göre Amerika'daki radyolojist sayısı yıllar içinde doğrusal bir biçimde artmaya devam ediyor. Üstelik ChatGPT'nin yaygınlaştığı 2022 sonrasında bile bu artışta hiçbir kırılma yok. Ortalama yıllık gelir 500.000 dolar seviyesine yükselmiş durumda. FDA, radyoloji alanında 700'den fazla modelin kullanımına izin vermiş, Amerika'daki radyolojistlerin yüzde 48'i bu modelleri aktif olarak kullanıyor. Buna rağmen radyolog ihtiyacı azalmıyor, aksine artıyor.
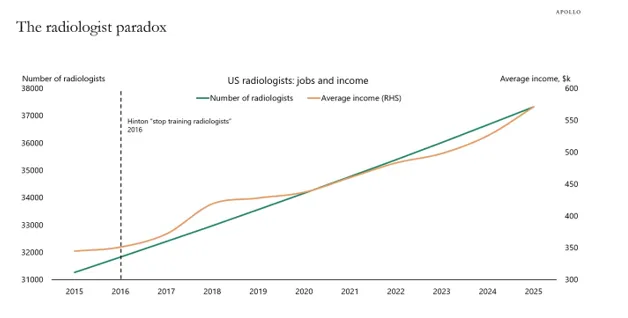 Figür 2: Amerika’daki radyolojist sayısının zaman içindeki değişimi.
Bu paradoksun nedeni de yine modellerin gerçek dünyada nasıl davrandığıyla ilgili. Görüntü işleme modelleri eğitim verisinden farklı bir hastanenin verisiyle karşılaştığında başarı oranları yüzde 20 oranında düşüyor. BMJ'de yayımlanan başka bir çalışma, en ileri görüntü işleme modellerinin bile kendi başlarına bırakıldığında aşırı tanı eğilimi gösterdiğini, bu durumun da hem operasyonel maliyetleri hem de hasta sağlığını riske atan müdahale zincirlerini tetiklediğini ortaya koyuyor. Üstelik radyolojistlerin çalışma zamanlarının yalnızca yüzde 36'sı görüntü yorumlamaya gidiyor; geri kalan zaman hastayla iletişim, asistan eğitimi, etik ve hukuki süreçler gibi modele devredilemeyecek alanlara harcanıyor.
İşin bir başka yüzü daha var, üstelik daha sinsi olanı. Topol'un Ground Truths bülteninde altını çizdiği başka bir çalışma, kolonoskopi sırasında yapay zekâyı asistan olarak kullanan hekimlerin adenom belirleme yeteneğinde yüzde 20'lik bir düşüş yaşadığını gösteriyor. Yani yapay zekânın yardımcı bir araç olarak gelmesi hekimin kendi kasını köreltebiliyor. Bu da uzun vadede yapay zekânın olmadığı bir anda hekimin elinde kalan beceri stokunu azaltıyor. T24'teki "Verimlilik hissinden kalkınma paradoksuna" başlıklı yazımda yapay zekânın bilişsel düzeyde sebep olduğu yetenek gerilemesinden bahsetmiştim. Anlaşılan o ki bu gerileme yalnızca masa başı meslekleri değil, ameliyathaneyi de teğet geçmiyor.
Peki tüm bunlar yapay zekânın tıpta hiçbir işe yaramadığı anlamına mı geliyor?
Elbette hayır. Topol'un kendisi de göz hastalıkları alanında yapılan tek merkezli randomize bir çalışmaya işaret ediyor. Bu çalışmada yapay zekâyı kullanan göz doktorlarının tanı doğruluk oranı yüzde 92,2 iken, kullanmayanlarda yüzde 75,4'te kalmış. Yine Kenya'daki 16 birinci basamak kliniğinde dil modelinin kullanıldığı bir başka çalışma, sınırlı kaynaklarla çalışan ortamlarda anlamlı bir katkı sunabildiğini göstermiş. Burada kritik bir ayrıntı var. Her iki örnekte de yapay zekâ doktoru ikame eden değil, ona eşlik eden bir araç olarak konumlanıyor. Yani tıpta doktor artı yapay zekâ denkleminden çıkan sonuç tek başına yapay zekânın değil, doktorun yapay zekâyla daha iyi performans gösterdiği yönünde.
Burada bir düşünme alanı açmak gerekiyor. Bilimsel makaleler hakem sürecinden geçip yayımlandığında, çalışmada test edilen model çoktan eskimiş oluyor. Science'taki çalışmada o1 modelinin değerlendirildiği günden bugüne ChatGPT 5.5 multi-modal yapısıyla devrede. Bu, yapay zekâ tarafının elinde sürekli bir kaçış yolu bırakıyor. "Bu çalışmadaki modelin başarısının sınırlı olmasının sebebi modelin eski olması" diyebiliyorlar. Ama bu argümanın da bir bedeli var. O da yeni modeli aynı katılıkta test etmek, prospektif klinik deneyler yapmak, kanıtı sağlam zeminde üretmek. Otonom araç şirketi Waymo 2009'da yola çıkmıştı. İnsan sürücülere kıyasla ciddi kazalarda yüzde 90'dan fazla azalma sağladığını gösteren süperinsan performansını kanıtlaması 15 yılı aldı. Tıbbi yapay zekâ için de benzer bir sabırlı kanıt birikiminin gerekli olduğunu görmek için derin bir teknik bilgiye gerek yok.
Bütün bu çıktıları bir araya getirdiğimizde, aslında The Guardian'ın sansasyonel başlığının bize anlattığı şey yapay zekânın doktorların yerini aldığı değil. Yapay zekânın laboratuvar koşullarında hazırlanmış vakalarda iyi performans gösterdiği ve bu performansın gerçek hayata aktarımının hâlâ ciddi sorularla dolu olduğu. Hinton'un on yıl önceki kehanetinin tutmaması da Apollo'nun grafiğindeki doğrusal artış da kolonoskopistin yapay zekâyla birlikte zayıflayan adenom tespit kası da bu sorulara birer cevap aslında.
Üstelik mesele yalnızca yapay zekânın gerçek dünyada zorlanması değil. Mesele aynı zamanda hekimin yapay zekâyı kullanırken kendi mesleki belleğini, refleksini, sezgisini ne ölçüde kaybettiği. Tıp pratiğinin "görmediğini görme", "eksik anlatılanı tamamlama", "riskin sözel ipucundan kokusunu alma" gibi hiçbir veri kümesine sığmayan boyutları var. Bir hastanın muayenehane kapısından girişindeki yürüyüşünden alınan bilgi de tanının bir parçası. Bunu modele veriyle aktarmanın yolu yok, çünkü bu bilginin kendisi henüz hekimin zihninde dahi formüle edilmemiş bir biçimde duruyor.
Belki de hepimizin sormadan duramaması gereken soru şudur. Doktor artı yapay zekâ denkleminin paydası gerçekten doktor artı yapay zekâ mı, yoksa yapay zekânın yavaş yavaş aşındırdığı, kendisini bir koltuk değneğine alıştırmış bir doktor mu? Çünkü ilk durumda kazandığımız bir şey var. İkincisinde ise bir süre sonra ne yapay zekânın yerine geçecek bir hekim, ne de hekimin yerine geçecek güvenilir bir yapay zekâ kalacak.
Referanslar
Booth, R. (2026, 30 Nisan). AI better at diagnosing patients than doctors, study finds. The Guardian. (Erişim tarihi 8 Mayıs 2026, https://www.techmeme.com/260502/p8 üzerinden)
Budzyń, K., Romańczyk, M., Kitala, D., Kołodziej, P., Bugajski, M., Adamczyk, P., Hassan, C., Wieszczy, P., Kamiński, M. F., & Mori, Y. (2025). Endoscopist deskilling risk after exposure to artificial intelligence in colonoscopy: A multicentre, observational study. The Lancet Gastroenterology & Hepatology. https://doi.org/10.1016/S2468-1253(25)00133-5
Buckley, T. A., Diao, J. A., Brodeur, P. G., Lin, S., Chen, J., McCoy, T. H., Manrai, A. K., & Rodman, A. (2026). Reasoning models for clinical decision-making. Science. https://doi.org/10.1126/science.adz4433
Manrai, A. [@arjunmanrai]. (2026, 30 Nisan). What do our results actually call for? Prospective clinical trials... [Post]. X. https://x.com/arjunmanrai/status/2050207284694048787
Mori, Y., Budzyń, K., & Kamiński, M. F. (2025). Endoscopist deskilling: An unintended consequence of AI-assisted colonoscopy? The Lancet Gastroenterology & Hepatology. https://doi.org/10.1016/S2468-1253(25)00164-5
Özdemir, O. (2026a). Verimlilik hissinden kalkınma paradoksuna. T24. https://t24.com.tr/yazarlar/ozancan-ozdemir/verimlilik-hissinden-kalkinma-paradoksuna,54478
Özdemir, O. (2026b, 1 Mayıs). Yapay Gündemler No 5-2026/5. Yapay Gündemler. https://yapaygundemler.substack.com/p/yapay-gundemler-no-4-20264-cd4
Shaw, J. (2026, 30 Nisan). AI outperforms doctors in emergency room tasks, new Harvard study shows. Harvard Magazine. https://www.harvardmagazine.com/ai/ai-outperforms-doctors-diagnosis-harvard-study
Slok, T. (2026). The radiologist paradox. Apollo Global Management. https://www.apollo.com/wealth/the-daily-spark/the-radiologist-paradox
Stone, W. (2026, 30 Nisan). In real-world test, an AI model did better than doctors at diagnosing patients. NPR. https://www.npr.org/2026/04/30/nx-s1-5804474/ai-doctors-openai-patient-care-diagnosis
Topol, E. (2026, 3 Mayıs). The paradox of medical AI implementation: From missed opportunities to missing evidence. Ground Truths. https://erictopol.substack.com/p/the-paradox-of-medical-ai-implementation




